Servidores Vastec de Infraestructura para IA, Deep Learning y LLMs
Servidores diseñados íntegramente para alimentar las cargas de trabajo más exigentes del mundo actual. Desde el entrenamiento de Grandes Modelos de Lenguaje (LLMs) hasta la inferencia masiva de visión por computadora, maximizando el rendimiento de sus aceleradores.
Cada solución está optimizada para un conjunto específico de cargas de trabajo, garantizando máximo rendimiento y ROI.
1.ENTRENAMIENTO DE LLMs
Entrenamiento y despliegue de modelos de lenguaje masivos para atención al cliente automatizada, análisis legal o generación de código.
2.IA GENERATIVA
Creación de imágenes, video y audio sintético
3.INFERENCIA EN TIEMPO REAL
Acelera el análisis de genómica y química computacional para proyectos de investigación exigentes.
4.PROCESAMIENTO DE LENGUAJE NATURAL
Procesa información de data lakes, ETL y volúmenes de datos que pueden alcanzar petabytes.
5.CIENCIA DE DATOS Y ANÁLISIS PREDICTIVOL
Analiza simulaciones con postprocesado y renderizado avanzado.Visualiza grandes conjuntos de datos científicos.
6.VISIÓN ARTIFICIAL Y COMPUTER VISIÓN
Optimiza producción, logística y cadenas de suministro.Reduce costos y mejora la eficiencia operativa.
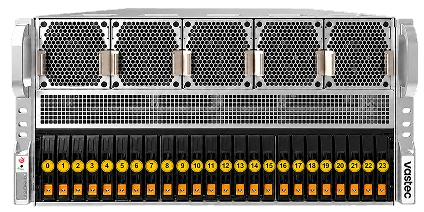
Servidores para IA y deep learning
Potencia y escalabilidad para tus modelos de IA
Servidores acelerados por GPU de ultra alto rendimiento, diseñados para entrenamiento de modelos complejos, visión por computadora y procesamiento de LLMs.
Arquitectura Desbloqueada
Nos enfocamos en evitar el cuello de botella entre el procesador Intel, la memoria y las GPUs. Placas base diseñadas para máxima latencia mínima y ancho de banda bruto.
Gestión Térmica Avanzada
El entrenamiento de IA genera calor extremo. Nuestros chasis están diseñados con rutas de aire presurizadas y ventilación de alta capacidad para mantener sus GPUs en la temperatura óptima de Boost las 24 horas.
Stack de Software Listo
Pre-configurados con los drivers CUDA, cuDNN, Docker y frameworks esenciales (PyTorch, TensorFlow) para que sus científicos de datos comiencen a programar desde el minuto uno.
¿Cómo construimos tu solución de IA?
1
Perfilar el Modelo (Model Profiling)
Analizamos si su carga de trabajo está limitada por la memoria de la GPU (VRAM), la capacidad de cómputo (TFLOPS) o la comunicación entre nodos.
2
Diseño de Topología GPU
Definimos el número exacto de GPUs por nodo (G100 vs G800) y la infraestructura de red de alta velocidad (InfiniBand o Ethernet RoCE) si requiere varios nodos G800.
3
Validación Térmica y Eléctrica
Verificamos que su centro de datos tiene la capacidad de enfriamiento y amperaje necesarios antes de encender los equipos.
4
Stacking y Benchmarking
Instalamos el software base y corremos pruebas de estrés (como ResNet-50 o pruebas de tokenización) para validar que el rendimiento es el esperado.
Impulsa tus proyectos de IA con la infraestructura adecuada
Hablemos de tus necesidades y diseñemos juntos la mejor solución en servidores para inteligencia artificial.

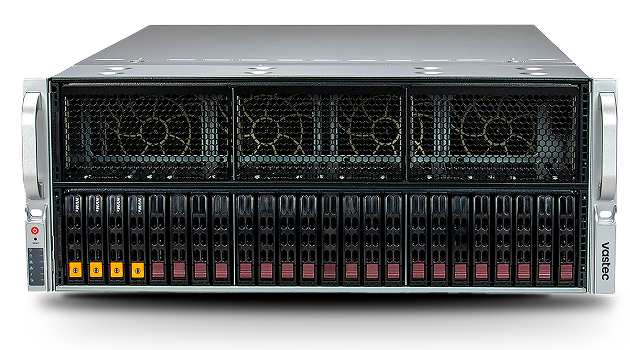
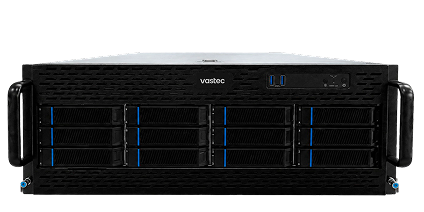
 2 x Intel® Xeon® 6530P hasta 4.1GHz
 256 GB DDR5 ECC RDIMM hasta 2 TB
 2 x NVIDIA RTX PRO 5000 Blackwell 48 GB GDDR7 ECC
 2 × SSD NVMe M.2 PCIe de 960 GB